AI 에이전트를 구축하는 모든 팀은 올바른 정보 없이는 에이전트가 질문에 안정적으로 답변하거나 올바른 조치를 취할 수 없다는 기본적인 사실을 발견하게 됩니다.
대규모 언어 모델의 컨텍스트 창이 커짐에 따라 에이전트에게 더 많은 정보를 제공하기만 하면 정확도가 향상될 것이라고 기대하기 쉽습니다. 실제로 컨텍스트가 많아지면 에이전트의 속도는 느려지고 비용은 증가하는 한편, 관련 없는 정보 속에 유용한 신호를 묻어버려 정확도가 낮아집니다.
그렇기 때문에 에이전트의 성공은 이제 컨텍스트 엔지니어링, 즉 에이전트가 작업을 효과적으로 완료하는 데 필요한 정보만을 선택, 구성 및 제공하는 관행에 달려 있습니다.
그리고 그 작업의 핵심은 검색에 있습니다. 중요한 것은 컨텍스트에 얼마나 담을 수 있느냐가 아닙니다. 천만 개 중 어떤 10개를 선택하느냐입니다.
MongoDB의 지능형 데이터 플랫폼은 Voyage AI의 동급 최고의 임베딩 및 리랭킹 모델을 복잡한 검색 시스템을 구축, 운영 및 발전시키기 위한 플랫폼과 통합합니다. 이제 Rerank 3 시리즈와 집계 파이프라인의 $rerank가 도입됨에 따라 개발자는 운영 데이터가 있는 것과 동일한 시스템에서 검색된 컨텍스트의 품질과 순서를 개선할 수 있습니다. 그 결과 에이전트가 조치를 취하는 데 필요한 컨텍스트를 제공하는 검색 시스템을 더 쉽게 구축할 수 있습니다.
조회 스택
효과적인 검색을 위해서는 유용한 정보를 찾고 무엇이 가장 중요한지 판단하며 이를 효율적으로 에이전트에게 전달하기 위한 조정된 시스템이 필요합니다.
전략은 시스템이 데이터를 검색하는 방법을 결정합니다. 키워드 검색은 정확한 텀을 표면화할 수 있는 반면, 벡터 검색은 개념적으로 유사한 콘텐츠를 찾습니다. 필터와 하이브리드 접근 방식은 정확성과 제어 기능을 추가하여 관련 컨텍스트만 조회되도록 합니다.
모델은 데이터에 대한 적합성이 어떤 모습인지 결정합니다. 더 강력한 임베딩 모델은 개념적 유사성과 쿼리 의도를 이해하여 벡터 검색이 더 나은 후보를 식별하도록 돕습니다. 리랭커를 사용하면 1단계 검색에서 리콜(재현율)을 최적화한 다음 후보 세트에서 가장 강력한 일치 항목을 분리할 수 있습니다.
올바른 엔진은 이러한 서로 다른 기술을 통합하여 시스템이 프로덕션에서 실행될 때 데이터를 최신 상태로 유지하고 쿼리를 효율적으로 유지합니다.
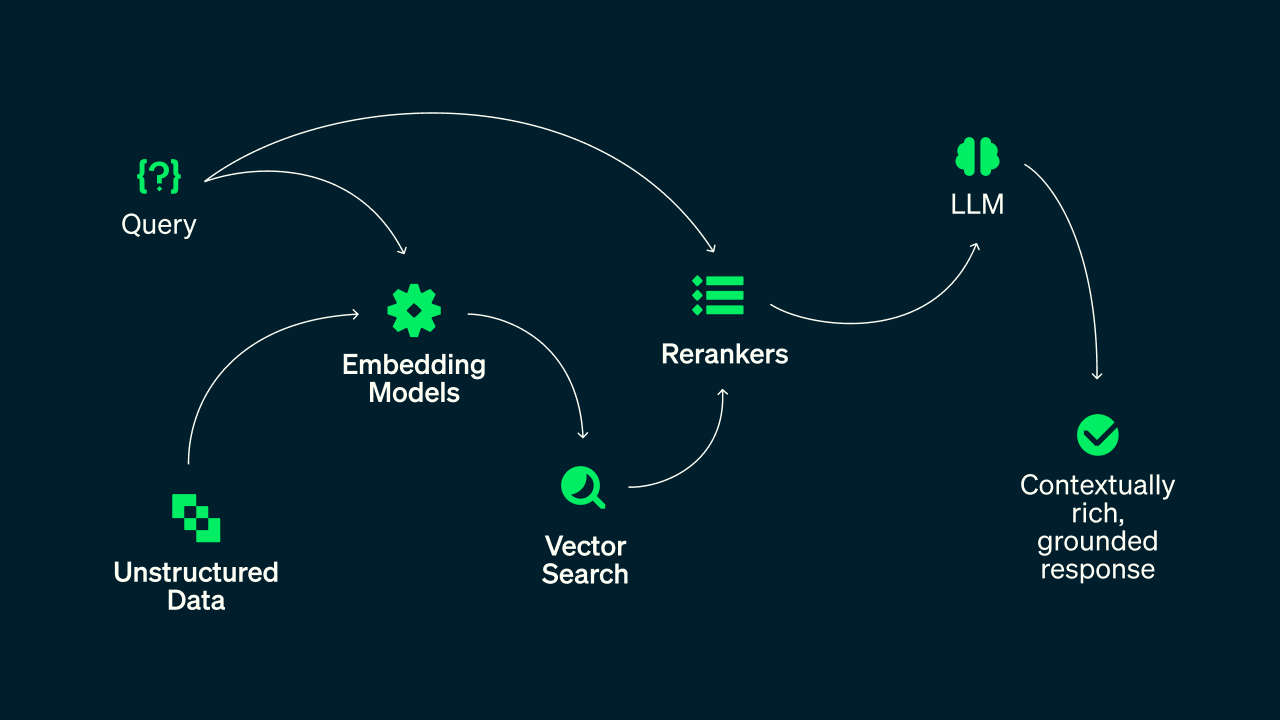
검색을 관리할 수 있는 통합 플랫폼이 없으면 작업이 빠르게 복잡해집니다. 임베딩에는 하나의 제공자를 사용하고, 리랭킹에는 다른 제공자를 사용할 수 있으며, 운영, 검색 및 벡터 데이터를 위해 여러 데이터베이스 벤더를 사용할 수 있습니다. 즉, 유지 관리해야 할 통합, 동기화 작업 및 API 호출이 늘어납니다. 또한 이로 인해 보이지 않는 문제가 발생할 수 있습니다. 벡터 검색 인덱스는 한 임베딩 모델 버전을 사용할 수 있지만 애플리케이션은 다른 버전을 사용하여 명시적인 오류를 일으키지 않으면서 관련성을 떨어뜨릴 수 있습니다.
그림 1. 연결 해제된 검색 파이프라인.
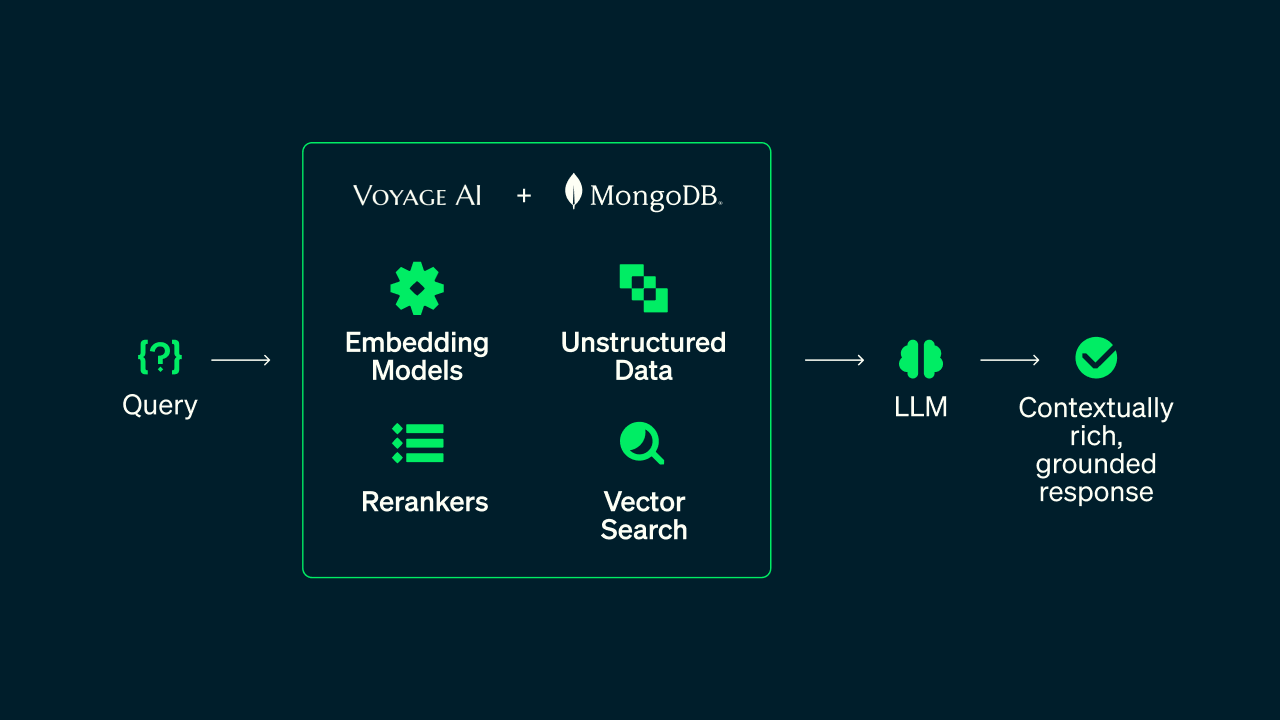
MongoDB는 이러한 요소를 하나의 플랫폼으로 통합합니다. 텍스트, 벡터, 하이브리드 및 필터 검색을 포함하여 개발자가 필요로 하는 검색 전략을 지원하며 이를 Voyage AI의 최첨단 임베딩 모델 및 리랭커와 페어링합니다. 자동화된 임베딩은 데이터가 변경될 때 벡터를 동기화된 상태로 유지하고, 네이티브 리랭크를 통해 개발자는 동일한 집계 파이프라인에서 결과를 구체화할 수 있습니다. 그 결과, 운영 데이터를 검색하고 올바른 검색 전략을 적용하고 결과를 재순위화하고 에이전트가 필요로 하는 컨텍스트를 반환할 수 있는 단일 쿼리가 탄생했습니다.
그림 2. MongoDB에서 제공하는 통합 검색 파이프라인.
모델
오늘 발표된 rerank-3 및 rerank-3-lite 는 모든 작업에서 향상된 정확도를 제공하며, 특히 긴 문서와 코드에서 가장 큰 폭으로 개선되었습니다. rerank-3은 전체적으로 Cohere Rerank v4.0 Pro보다 2.72%, Qwen3-Reranker-8B보다 3.02% 뛰어난 성능을 보입니다. rerank-2.5를 사용 중이라면 오늘 한 줄의 모델 이름 변경만으로 업그레이드가 완료됩니다. 동일한 API, 동일한 가격.
rerank-3는 초기 후보 세트가 어떻게 조회되는지에 관계없이 관련성을 개선합니다. 아래 표는 여러 일반적인 1단계 검색 방법에 걸친 정확도 향상을 보여줍니다.
표 1. 정확도 비교.
엔진
MongoDB는 이 모든 과정의 운영 검색 엔진이며 모든 전략은 애플리케이션이 이미 쓰기 (write)하는 데이터에 대해 기본적으로 실행됩니다. 어휘 검색(Lexical search)은 식별자, 오류 코드, 정확한 제품 이름을 찾아냅니다. 벡터 검색(Vector search)은 개념과 패러프레이즈를 찾아냅니다. 하이브리드 검색은 두 가지를 결합하고 메타데이터 필터를 통해 후보를 충분히 작게 설정하여 빠르게 처리합니다. 어떤 것도 데이터를 별도의 시스템으로 이동하거나 두 개의 복사본을 동기화하여 보관할 필요가 없습니다.
자동화된 임베딩은 일반적으로 중단되는 부분을 처리합니다. 벡터는 Atlas UI에서 토큰 소비량 및 인덱스 상태를 볼 수 있는 실시간으로 필드 수준에서 생성 및 새로 고침됩니다. 소유할 임베딩 작업이 없고 인덱스가 빌드된 모델 버전과 쿼리가 실행되는 모델 버전 간의 분할 가능성이 없습니다.
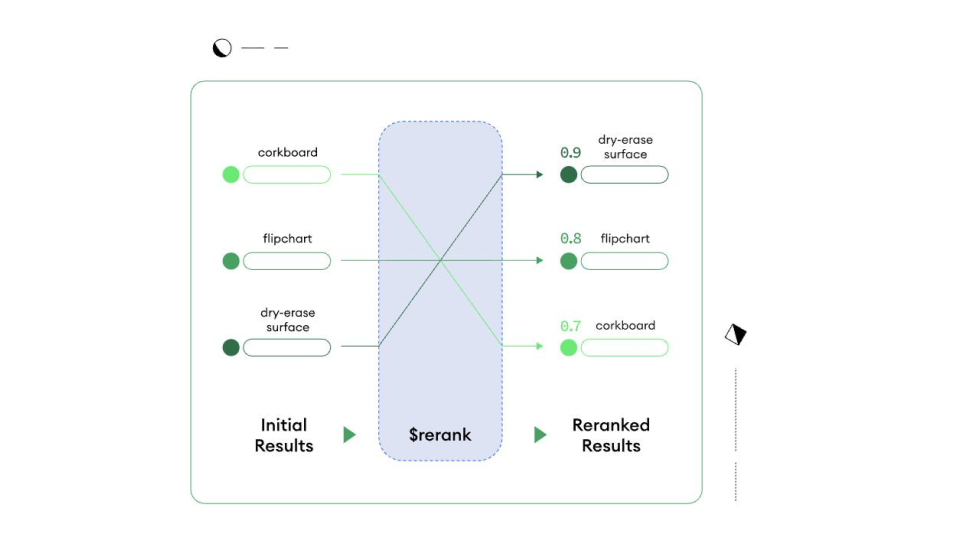
오늘 제공되는 $rerank는 해당 동일한 파이프라인에 최종 정렬 단계를 추가합니다. 이전 단계에서 생성된 모든 후보 세트를 가져와 rerank-3 또는 rerank-3-lite로 다시 점수를 매길 수 있는 인덱스 없는 단계입니다. 별도의 벤더, 외부 API 호출, 애플리케이션 코드의 재조립 단계가 없습니다. 이는 에이전트가 하나가 아니라 작업당 여러 번의 조회 호출을 수행할 때 중요합니다.
그림 3. 조치 중인 $rerank.
그래비티: 작동 방식
Gravity는 AI 시대를 위한 광고를 최적화하는 광고 네트워크를 구축하고 있습니다. 관련성은 있으면 좋지만 없어도 되는 것이 아니라, 그 자체로 제품입니다. 그들의 문제는 회상이 아니었습니다. 초기 임베딩 및 리랭킹 모델은 관련성 점수를 너무 밀접하게 군집화하여 Gravity는 강력한 일치와 약한 일치를 확신할 수 없었습니다.
Gravity의 공동 창업자이자 CTO인 Leo Martinez는 “우리가 벤치마크에서 발견한 가장 큰 점은 Voyage AI가 적합하지 않은 후보를 구별하고 적합한 후보를 실제로 홍보할 수 있는 능력이었습니다”라고 말했습니다. Voyage AI로 전환함으로써 검색 지연 시간이 약 50% 단축되었고 요청 볼륨이 증가함에 따라 정확도가 향상되었습니다.
격차 해소
검색 품질은 MongoDB가 에이전트 실행을 위해 구축 중인 한 계층입니다. MongoDB 9.0과 Atlas Infinite는 에이전트 워크로드가 생성하는 폭발적인 트래픽을 수용하는 성능 및 탄력적 확장 계층입니다. Atlas Agent Engine은 세션 전반에 걸쳐 에이전트에게 영구적인 컨텍스트와 가드레일을 제공하는 메모리 및 거버넌스 계층이며, Atlas Vector Search와 Voyage AI가 지원하는 검색입니다. 에이전트는 무엇을 할지 결정하기 전에 무엇을 검색할지 결정합니다. 잘못된 검색보다 더 빠른 인프라는 더 빨리 잘못된 것에 따라 조치를 취한다는 것을 의미합니다.
검색을 올바르게 수행하는 데 복잡한 아키텍처가 더 이상 필요하지 않습니다. 자동화된 임베딩은 임베딩을 처리하고, $rerank는 순서를 처리하며, 둘 다 MongoDB의 운영 데이터에 대해 직접 실행됩니다. 이 모델은 Atlas Embedding and Reranking API를 통해서도 독립적으로 사용할 수 있습니다.
다음 단계
자동화된 임베딩(Automated Embedding)과 네이티브 리랭킹(Native Reranking)을 여기에서 시작해보세요. MongoDB.local NYC에서 발표된 내용과 최신 제품 업데이트에 대한 모든 내용은 새로운 기능(What's New) 페이지에서 확인하세요.